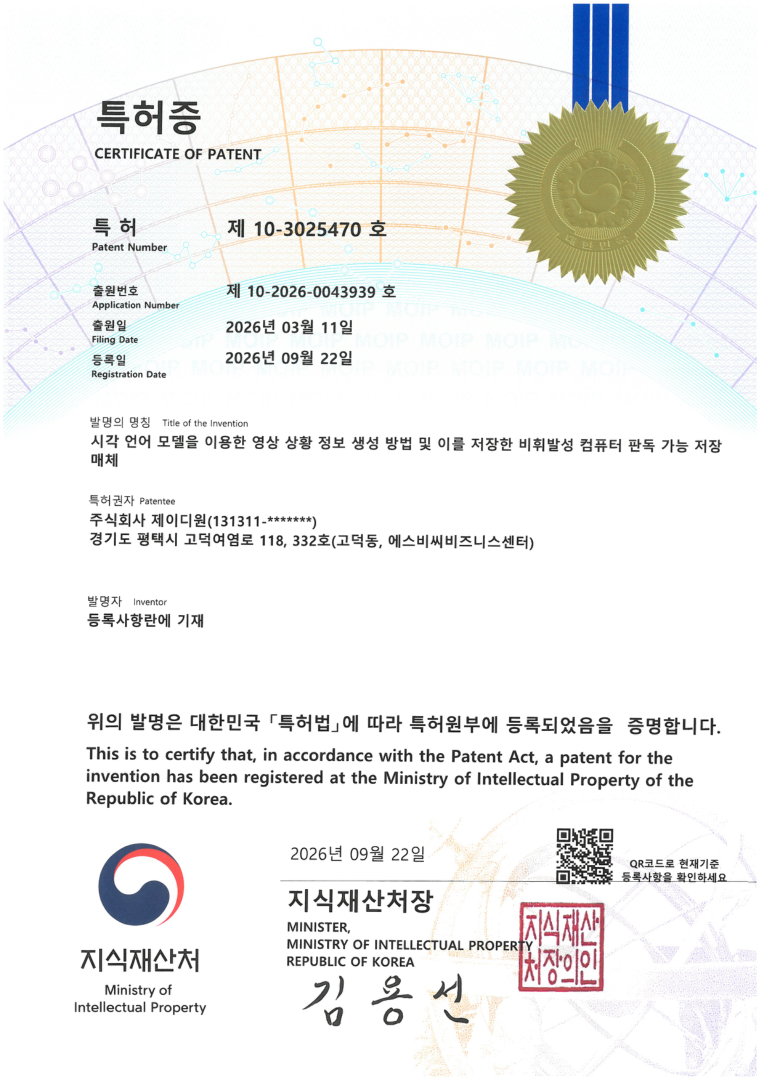
Vision Language Model
VLM 영상을 이해하는 AI
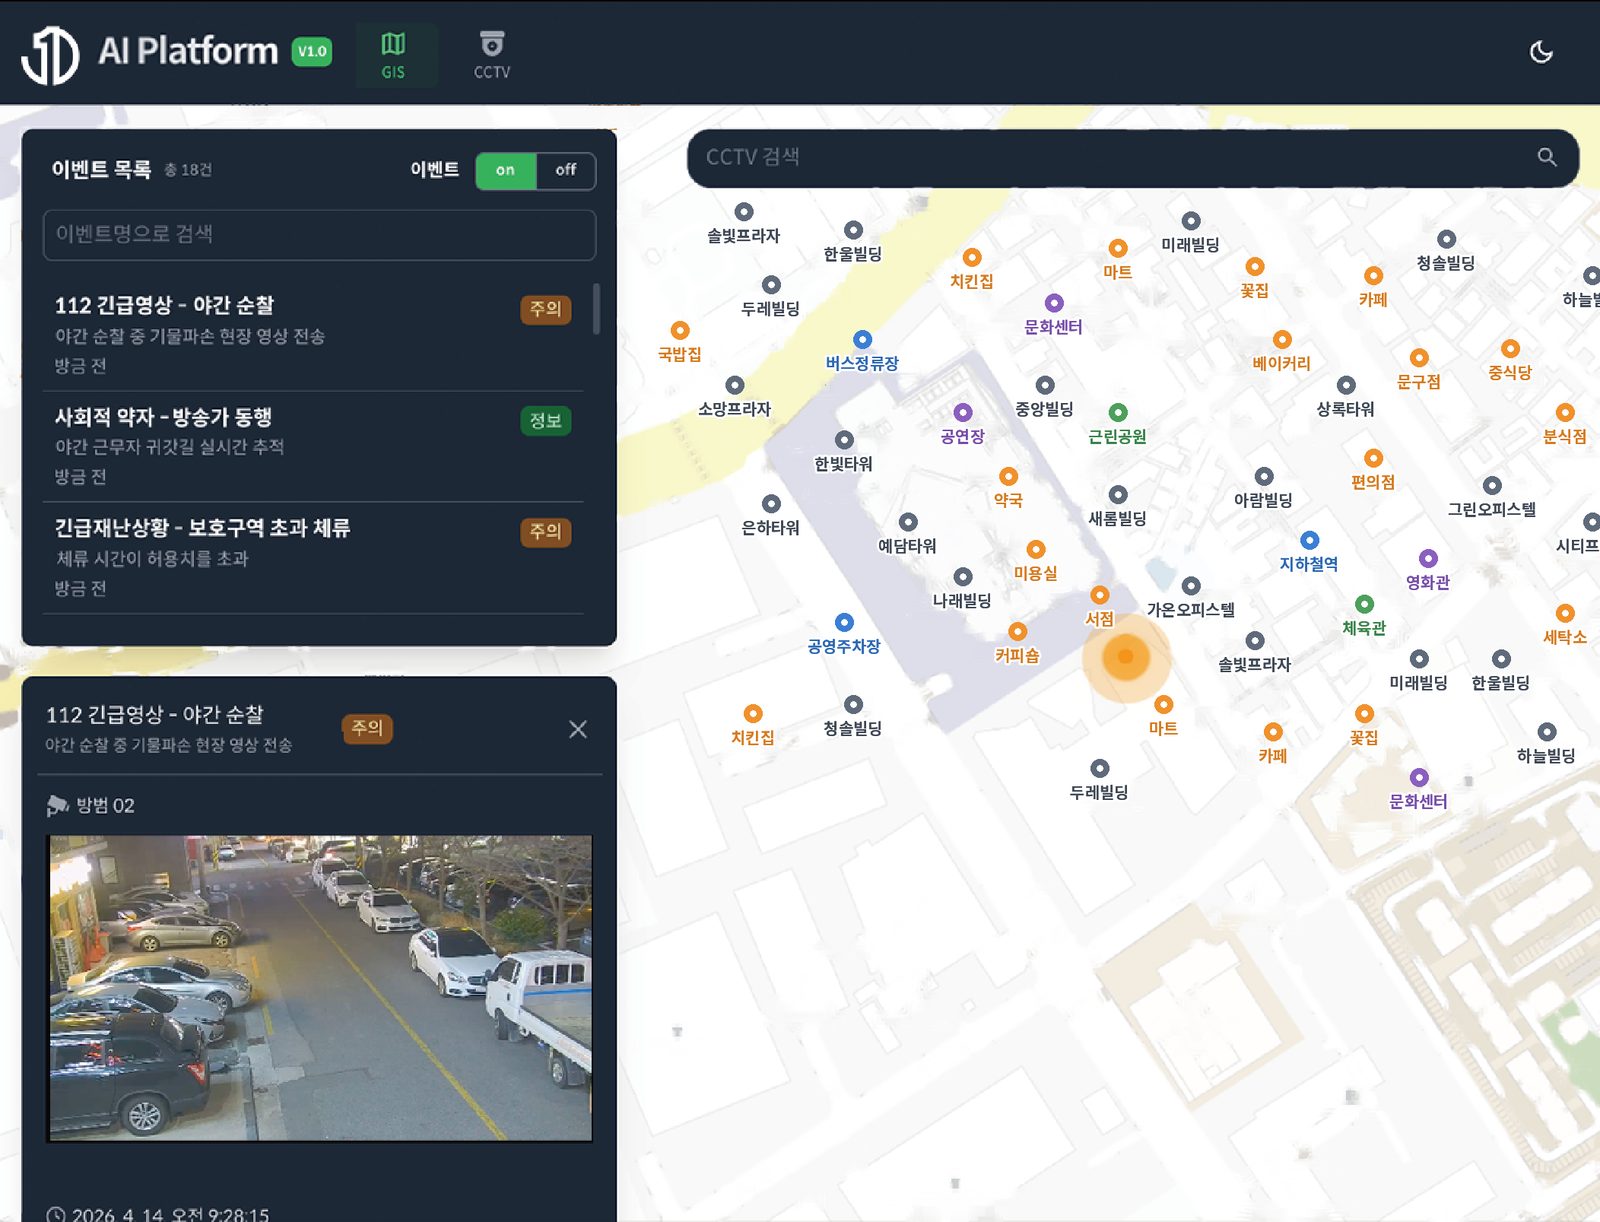
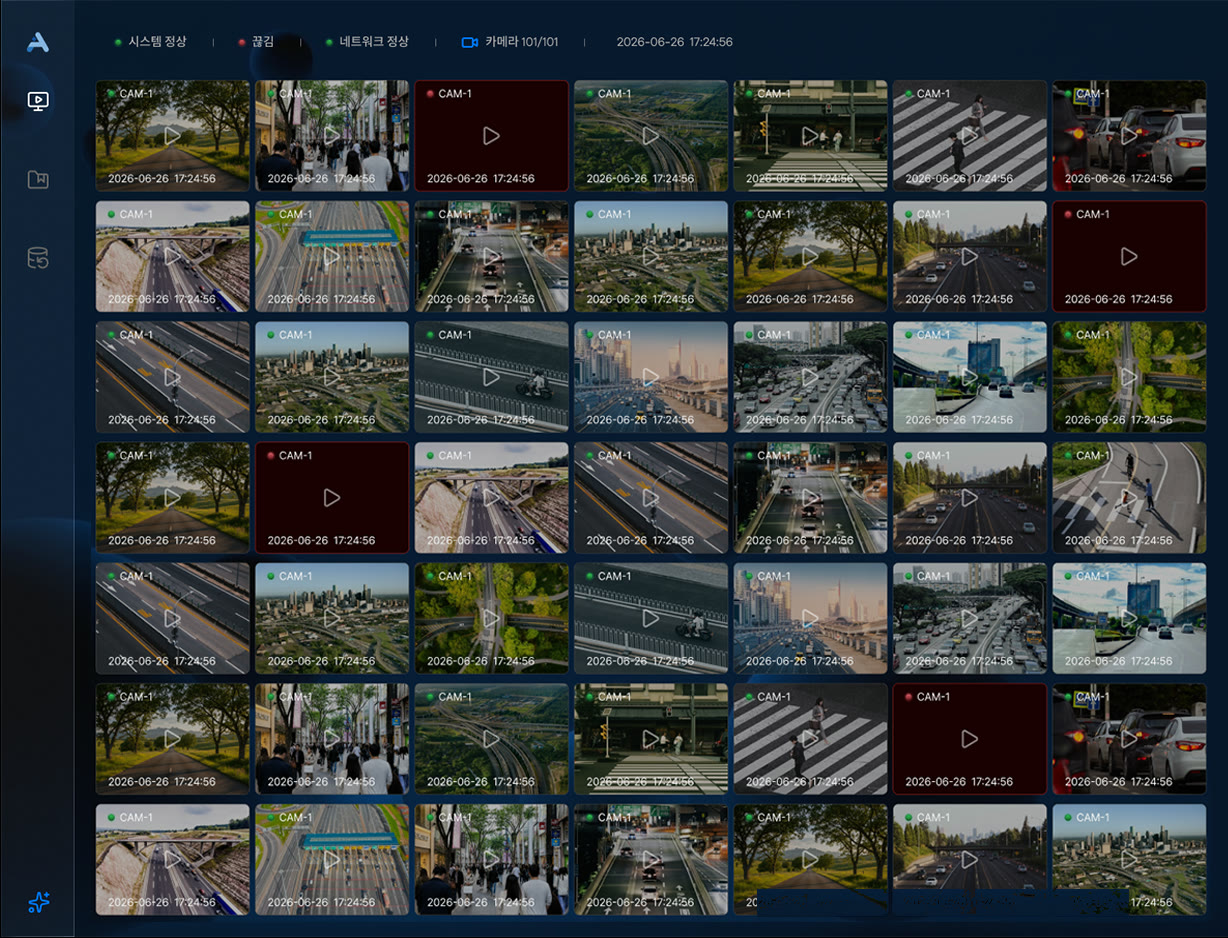
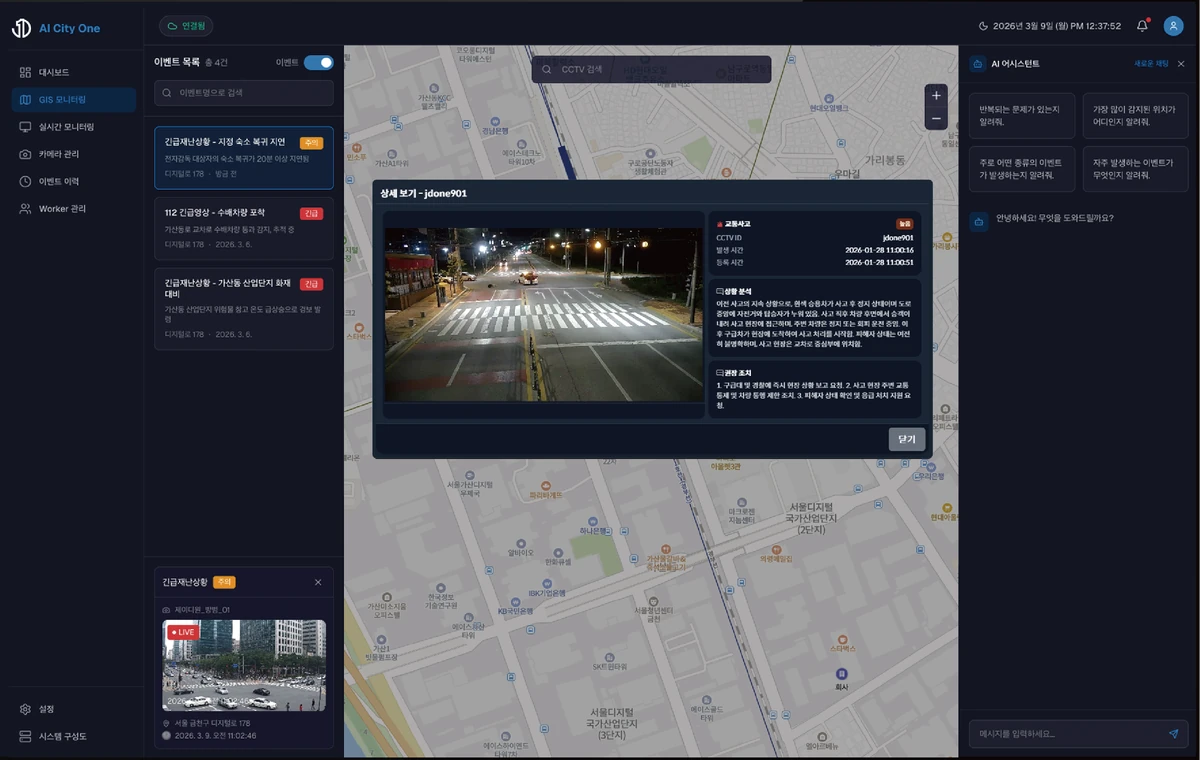
기존 CCTV AI가 “사람이 있다”처럼 물체를 발견하는 수준이었다면, VLM은 현장 전체를 언어로 이해하고 설명합니다. “교차로 중앙에 두 차가 충돌한 후 정지했고,
두 차가 파손된 것으로 보인다.”
솔루션에 AI를 더하다
제이디원
Just Do One
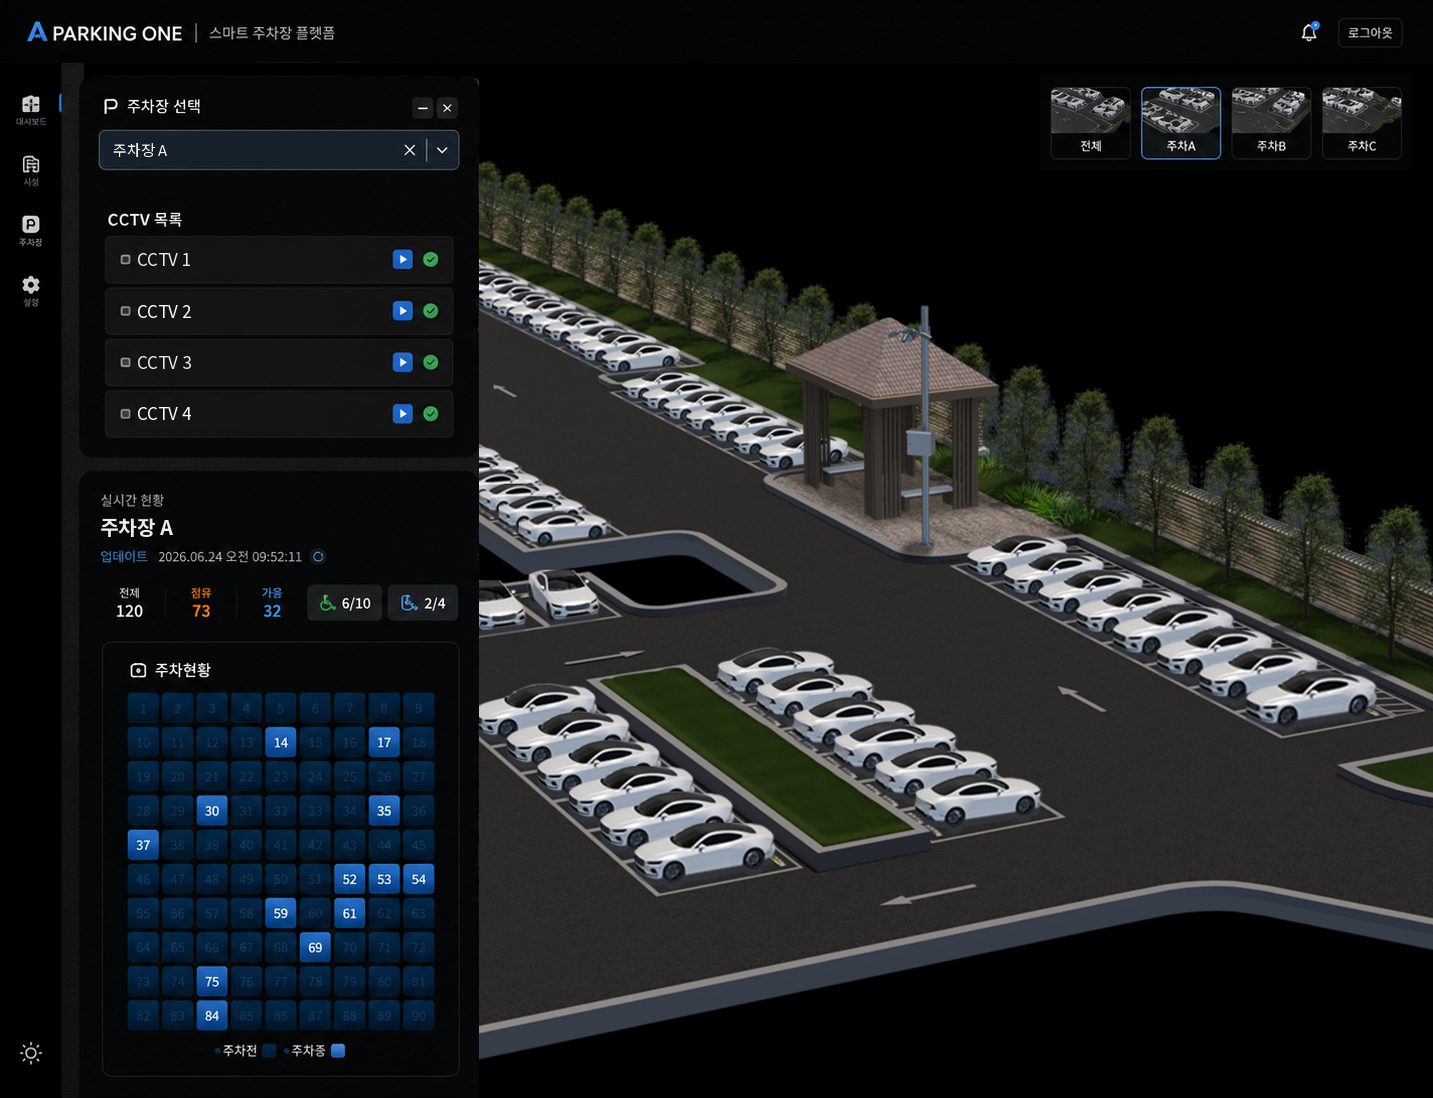
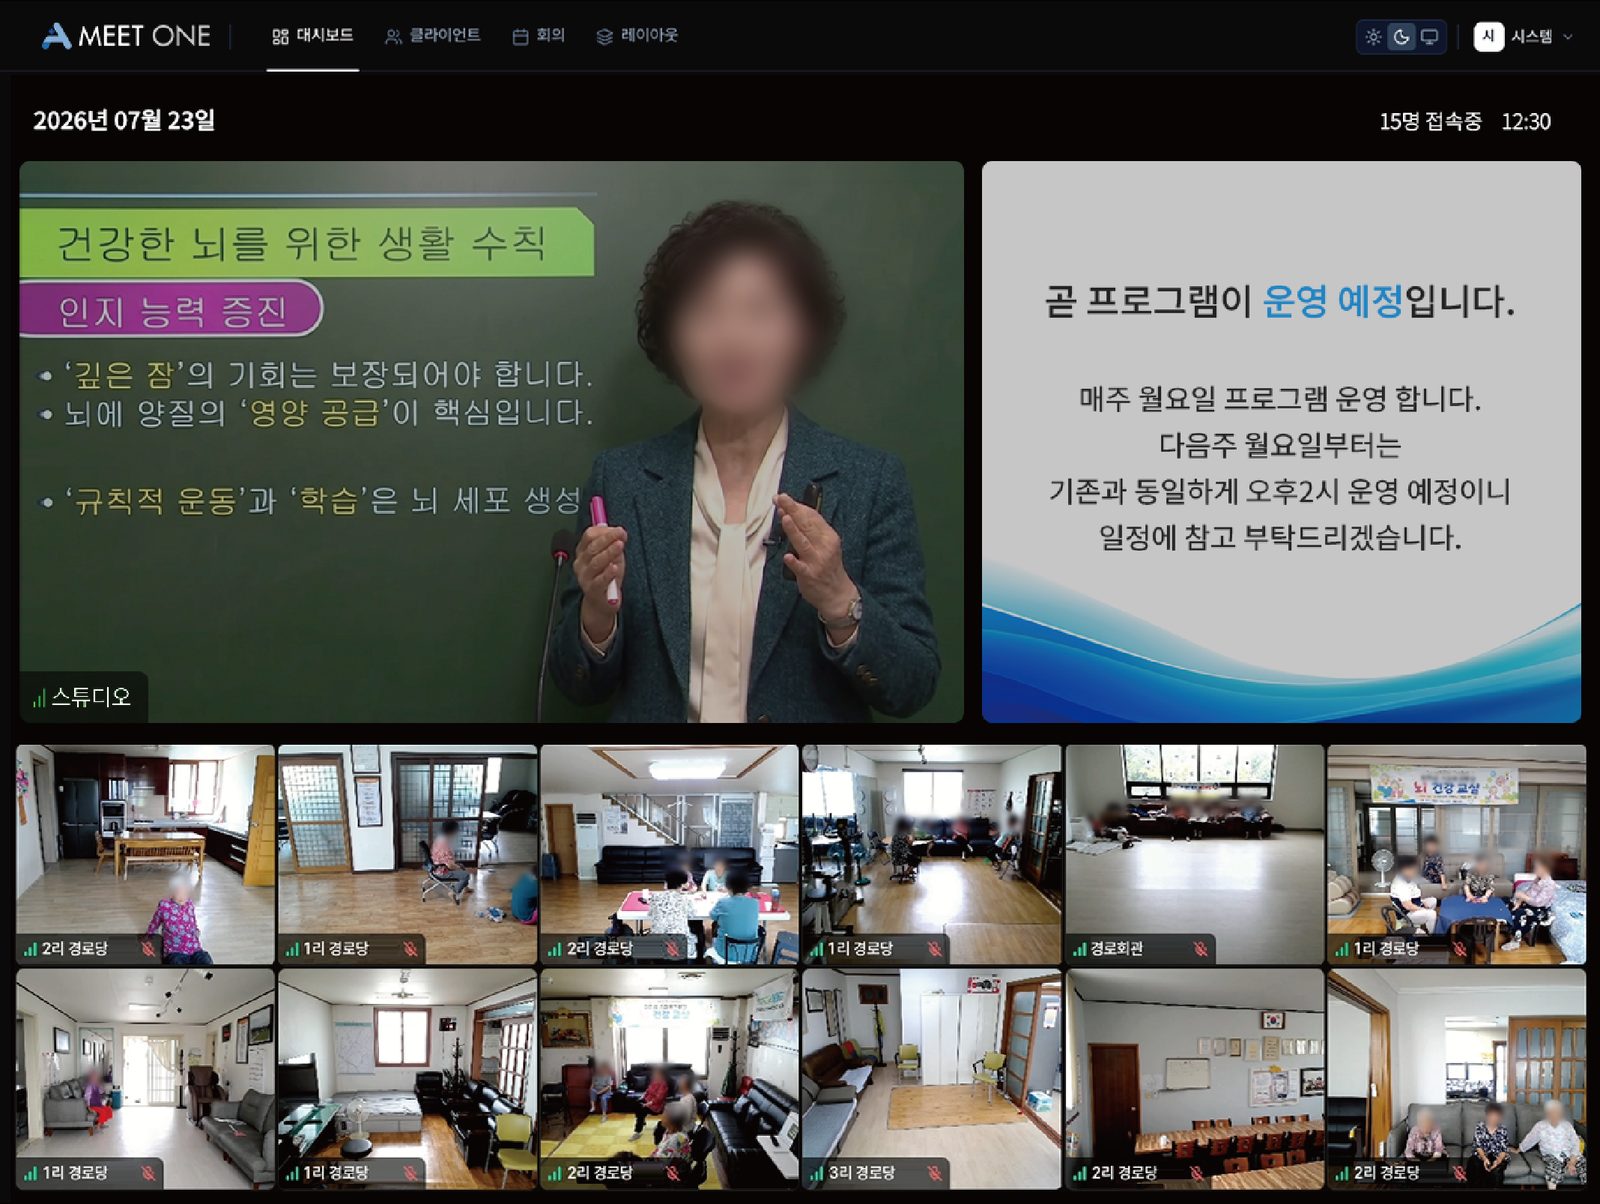
제이디원은 AI, 화상회의, 스마트 주차장, 데이터 허브를 기반으로 혁신과 신뢰를 추구하는 기업입니다.
끊임없는 연구와 창의적인 기술로 더 안전하고 편리한 세상을 만들어가며, 고객과 함께 성장하는 파트너가 되겠습니다.
제이디원은 AI와 혁신 기술로 더 안전하고 편리한 세상을 만들며, 고객과 함께 성장합니다.
솔루션에 AI를 더하고, 사람과 세상을 연결한다.


Vision Language Model
기존 CCTV AI가 “사람이 있다”처럼 물체를 발견하는 수준이었다면, VLM은 현장 전체를 언어로 이해하고 설명합니다. “교차로 중앙에 두 차가 충돌한 후 정지했고,
두 차가 파손된 것으로 보인다.”
Large Language Model
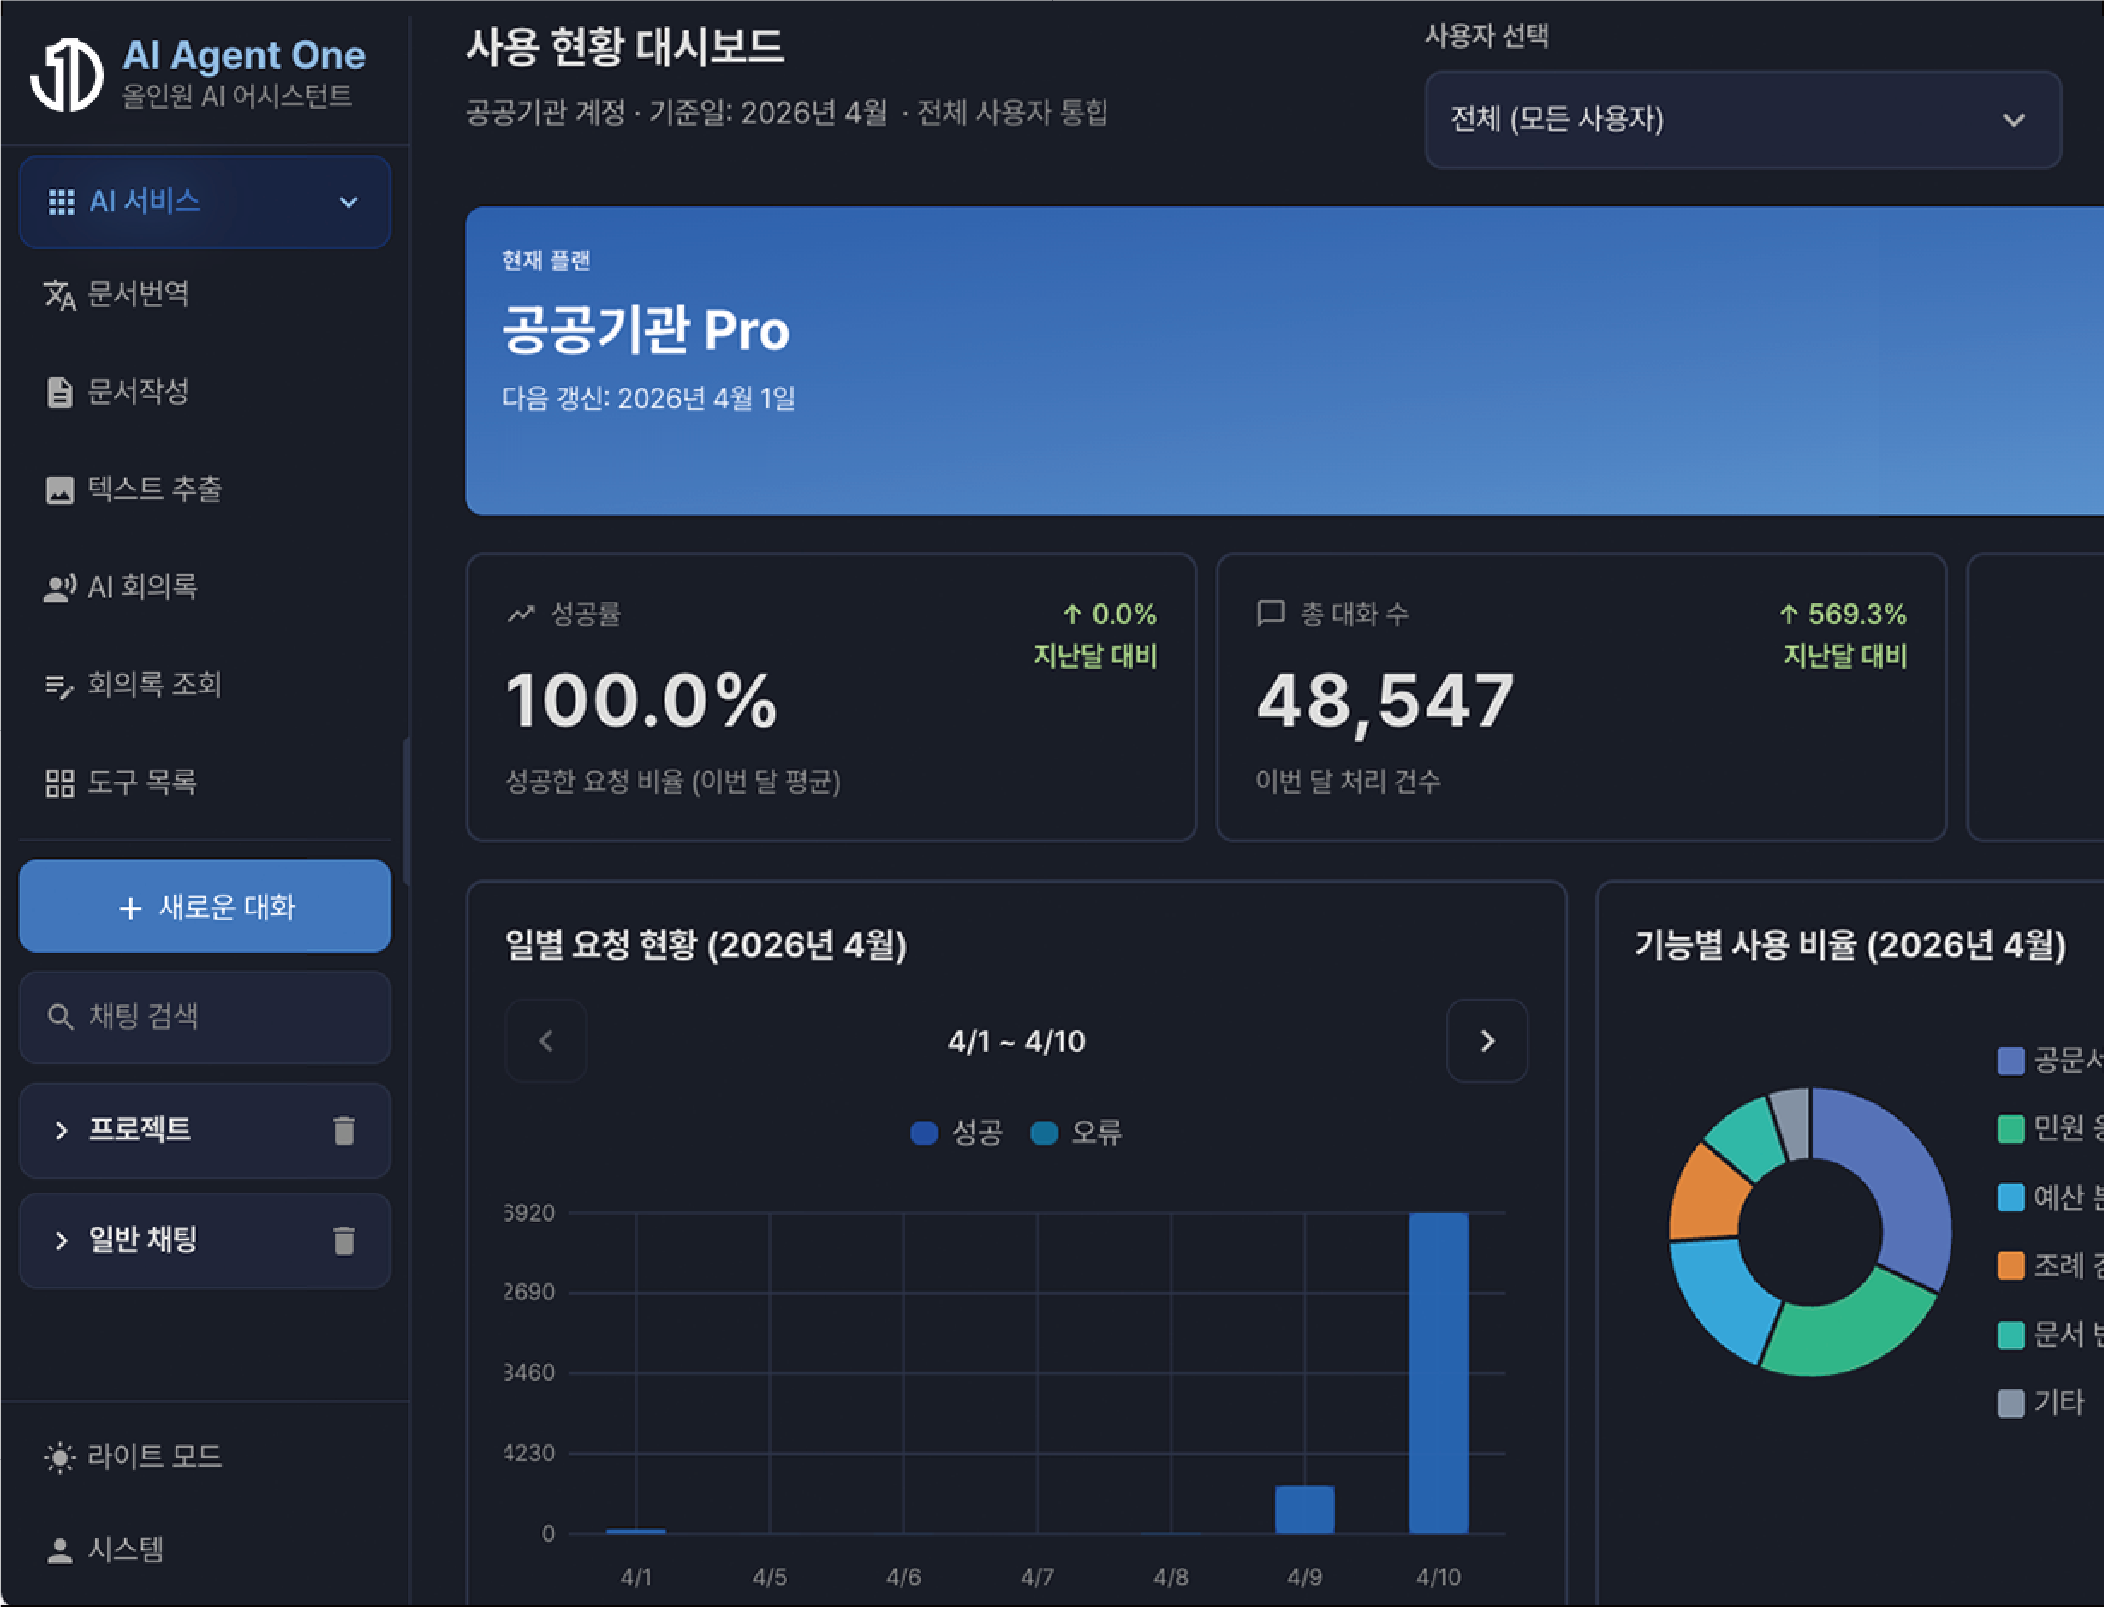
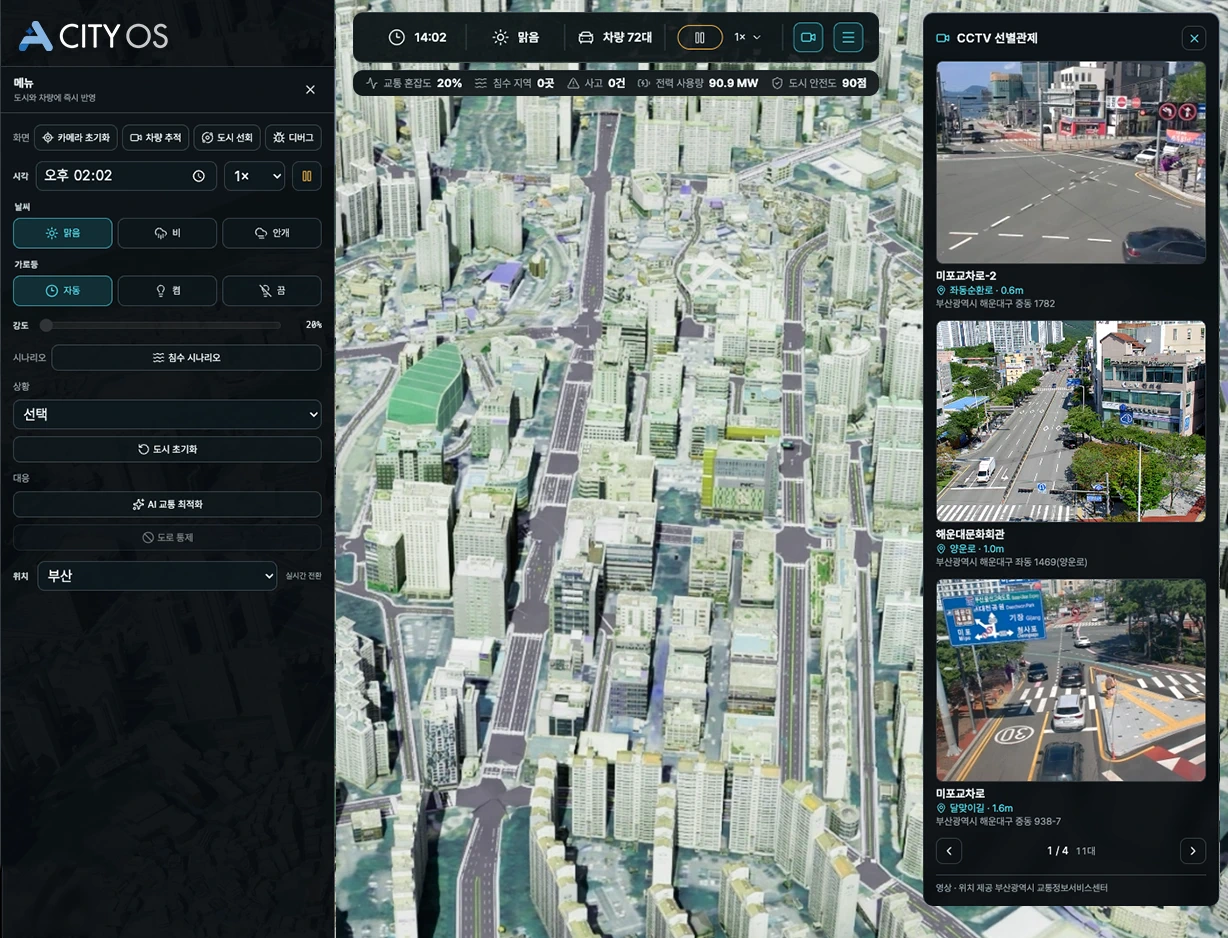
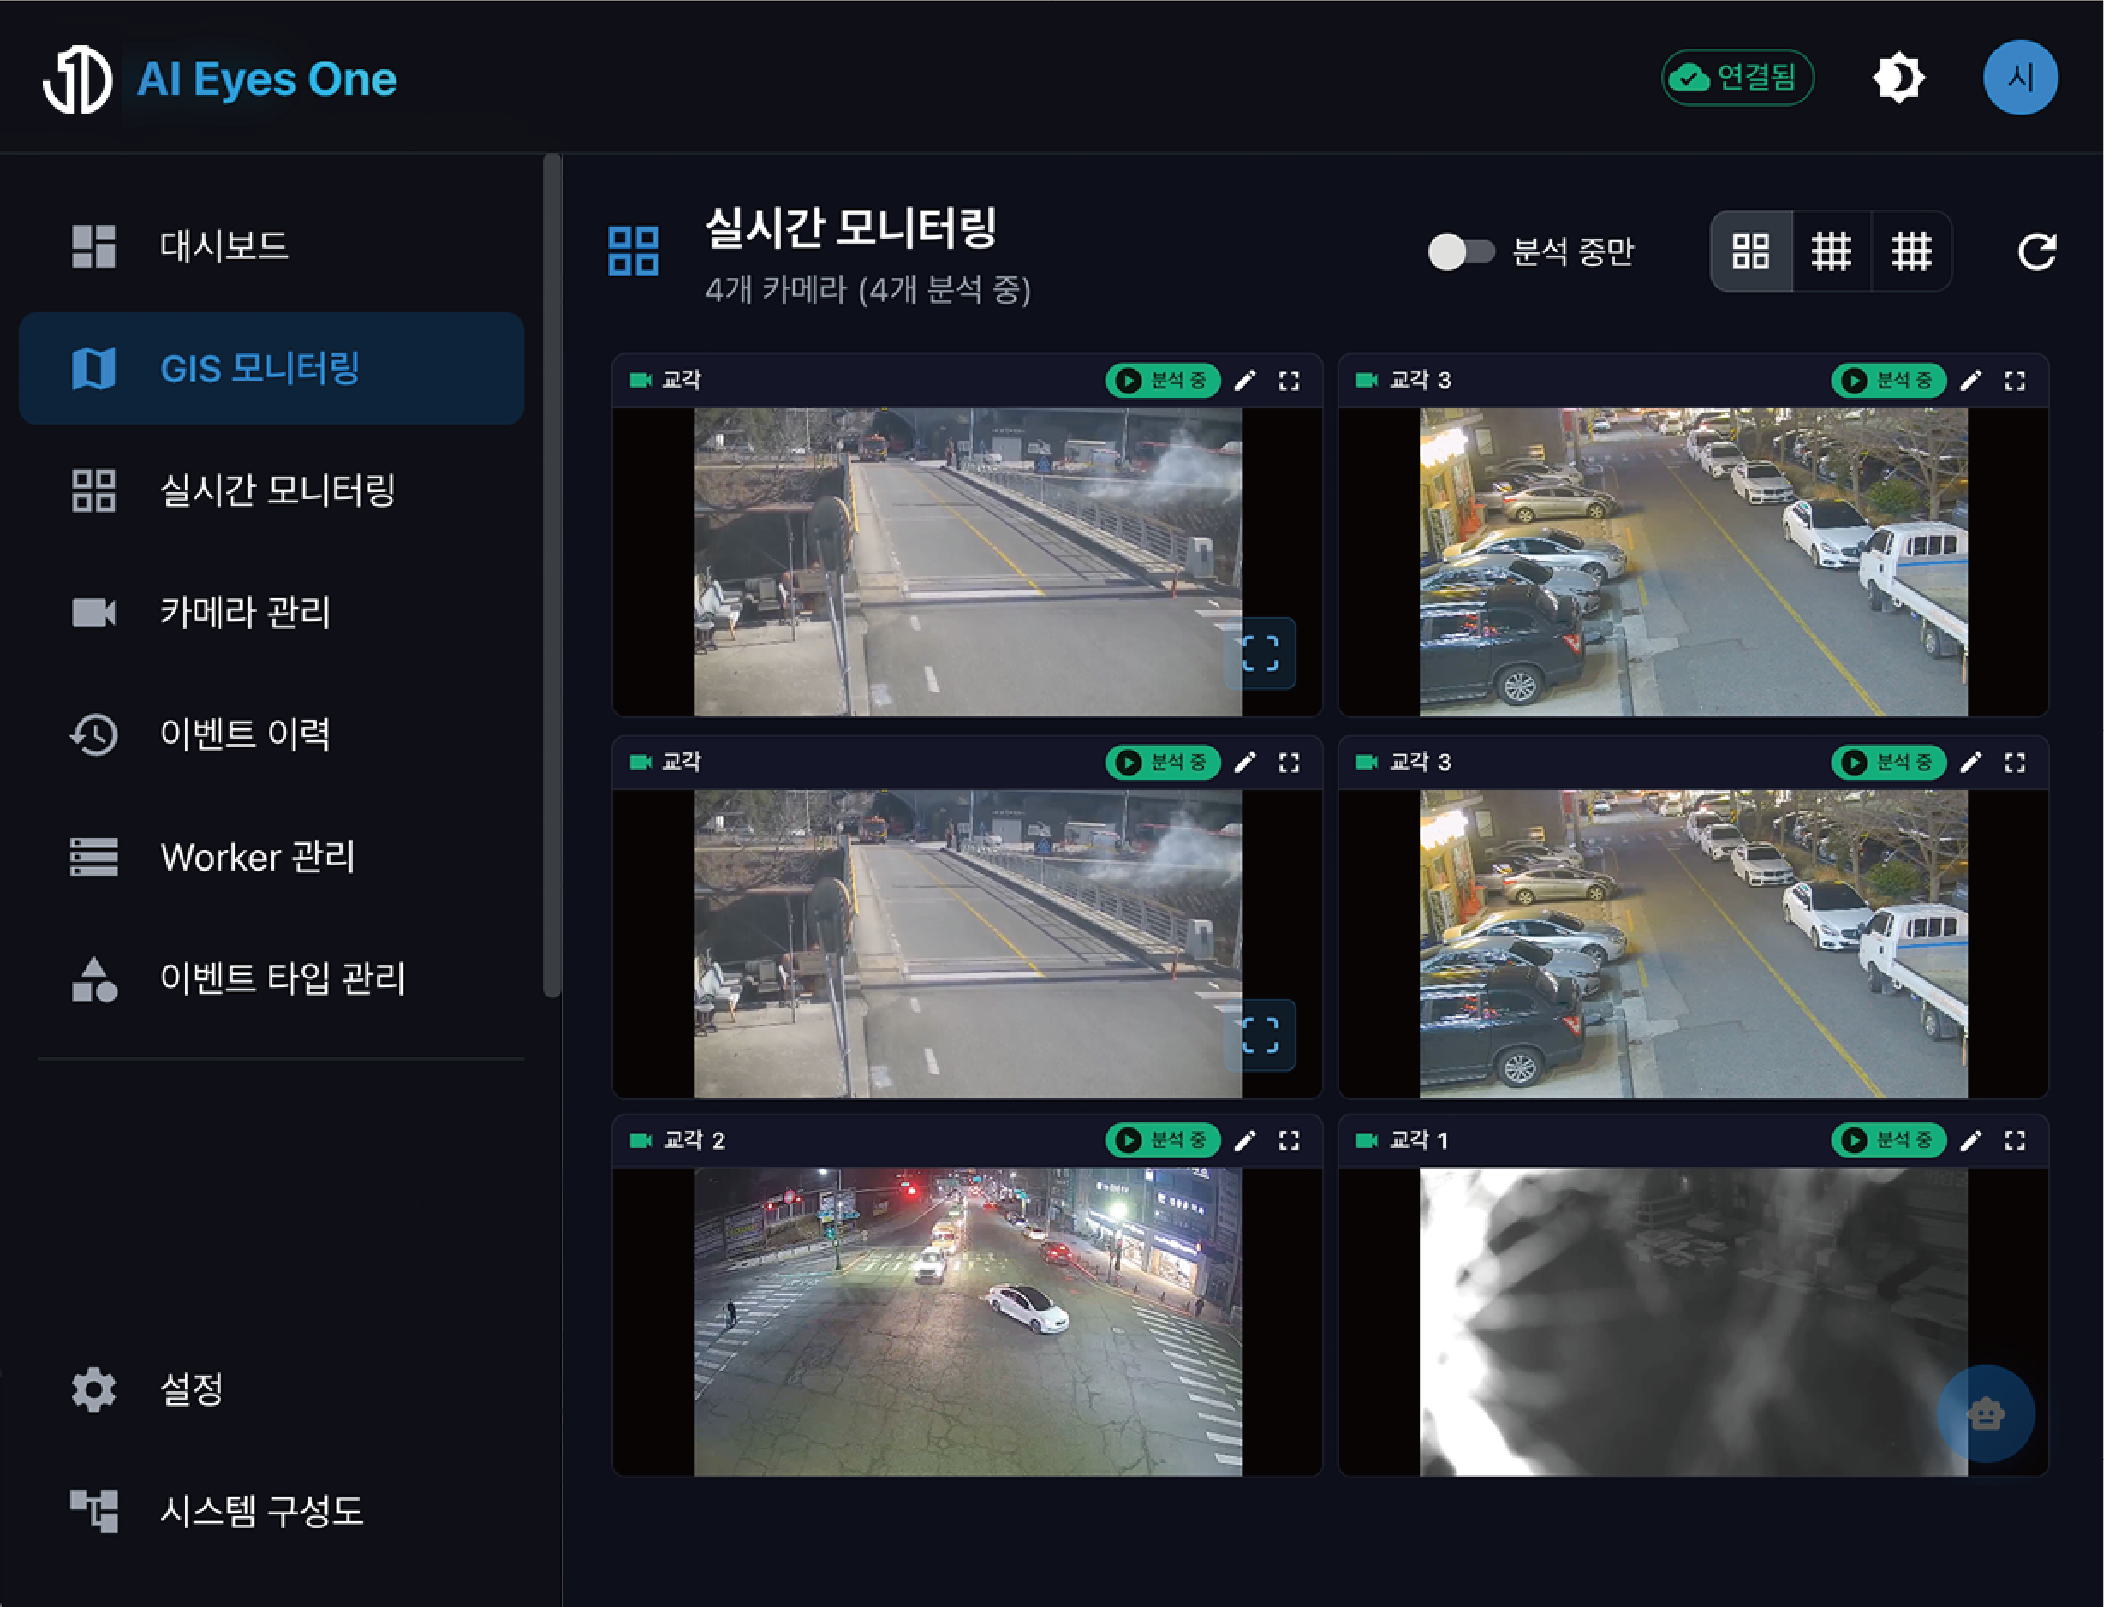
“이번 달 가장 사고가 많이 발생한 교차로가 어디야?”라고 말로 물어보면 AI가 데이터를 찾아 지도와 통계로 답을 보여주고 복잡한 시스템 조작 없이 말로 하는 행정을 가능하게 합니다.

Retrieval Augmented Generation
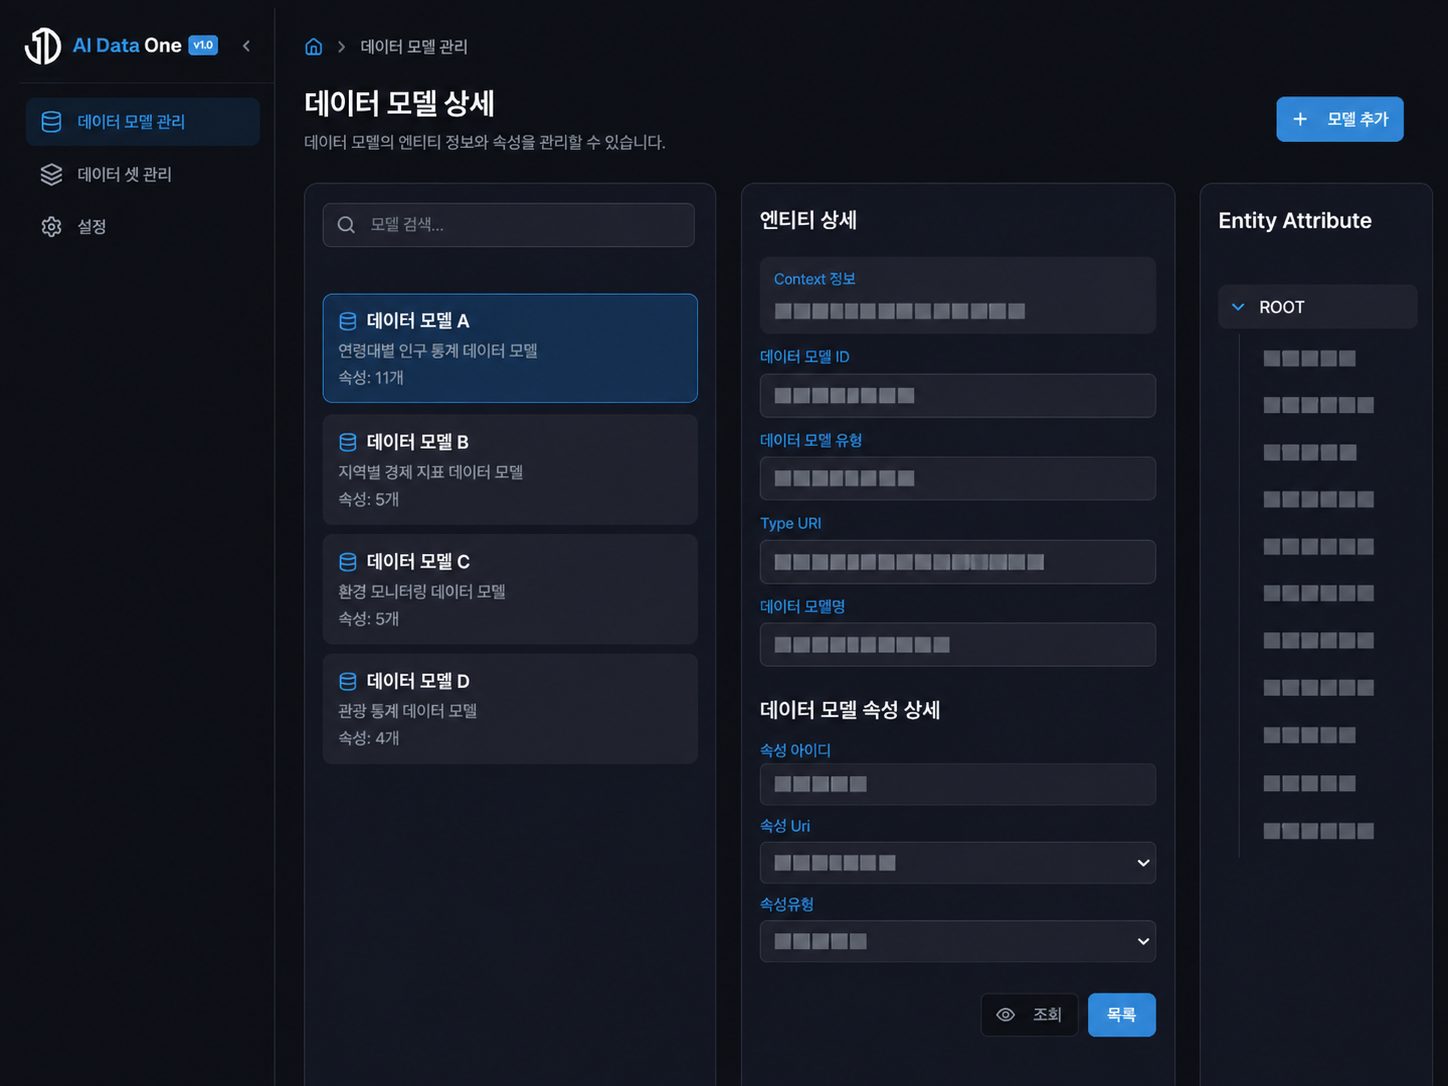
직접 등록한 내부 문서, 지침서, 규정집, 매뉴얼 등 기관의 지식 데이터를 검색·분석해 최적의 답변을 생성합니다.
최신 정보를 기반으로 신뢰도 높은 근거를 제공해 답변 정확성을 높이고, 필요한 정보를 빠르게 찾아 업무 효율과 의사결정 속도를 향상시킵니다.

JDONE Solution


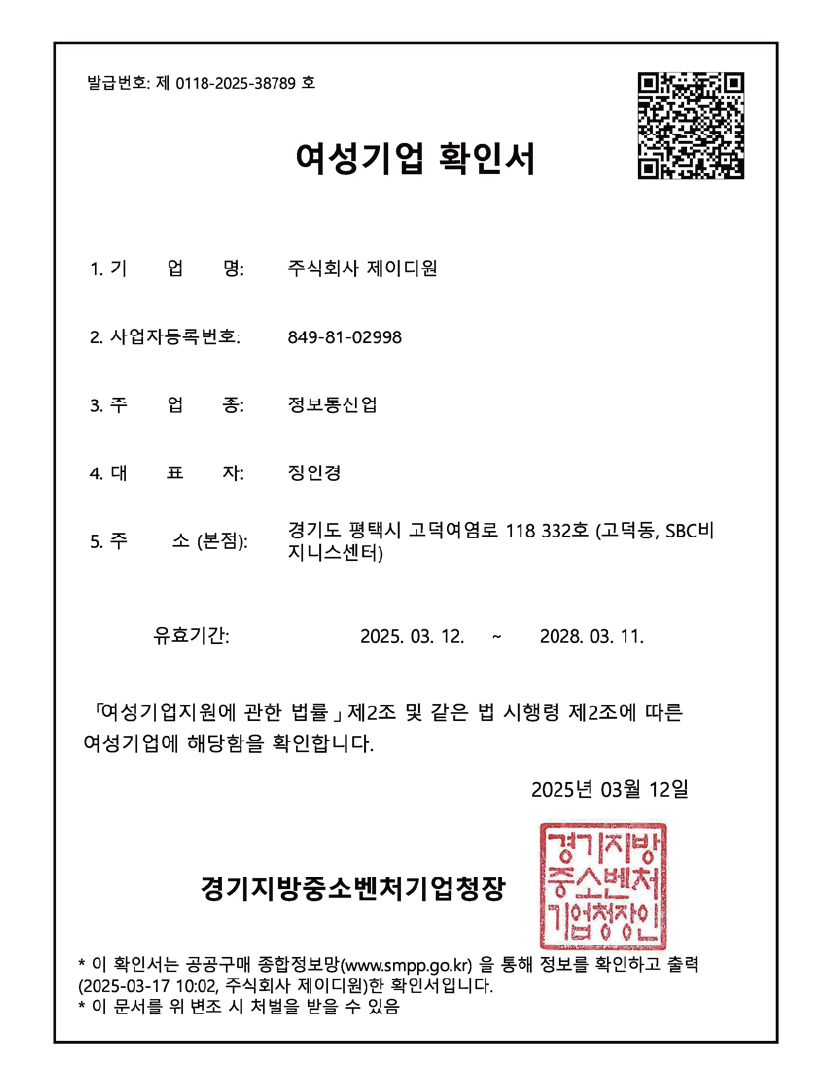
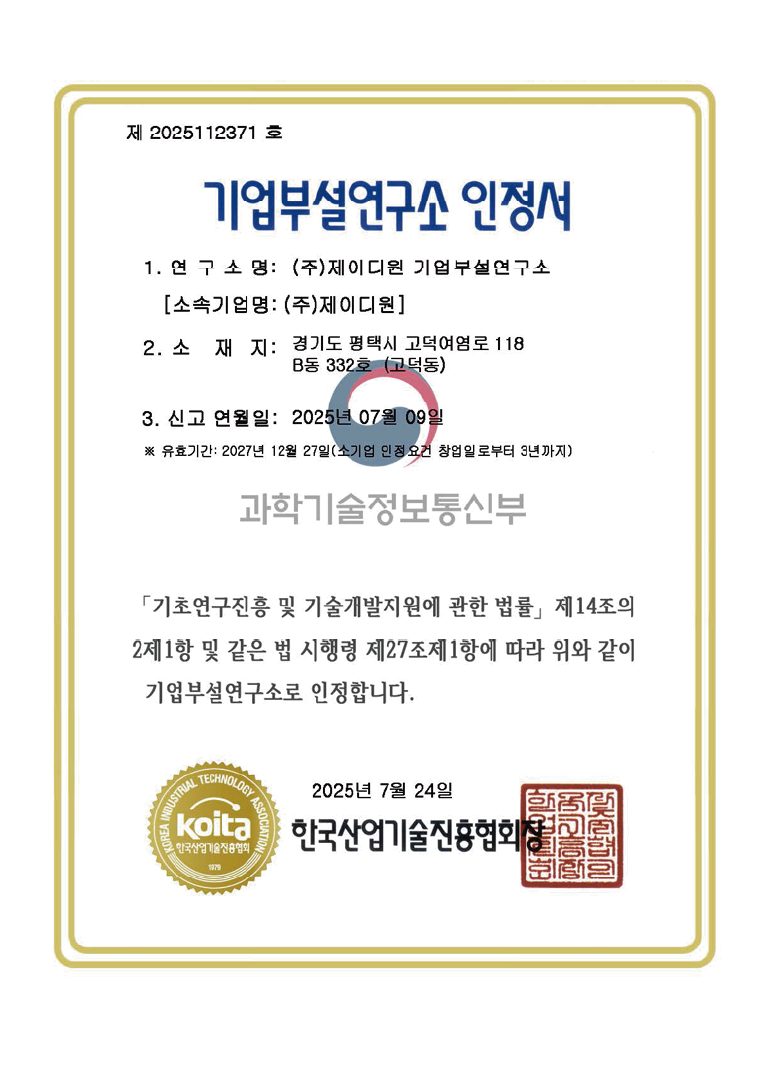
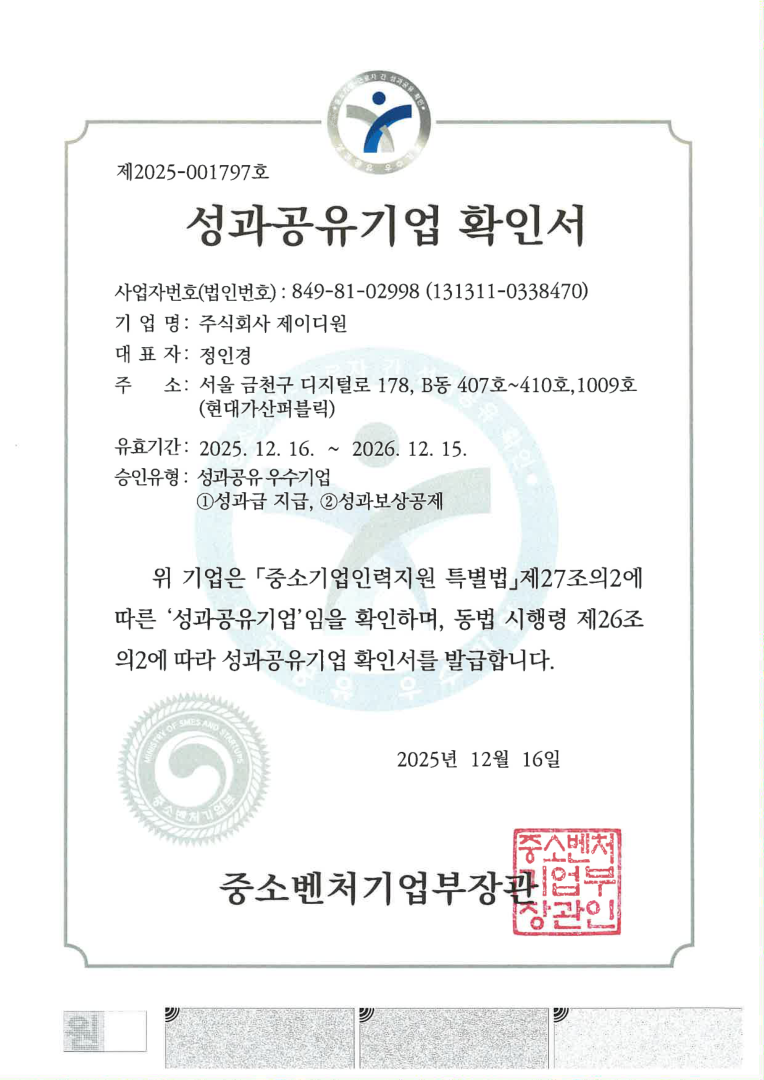
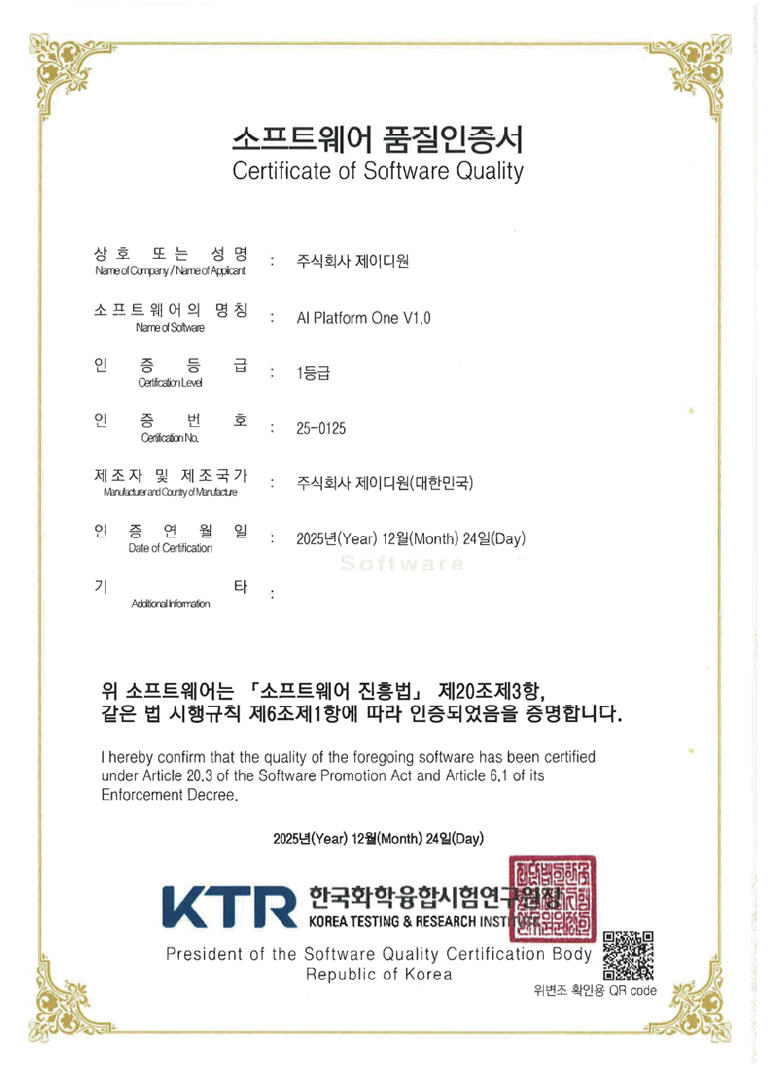
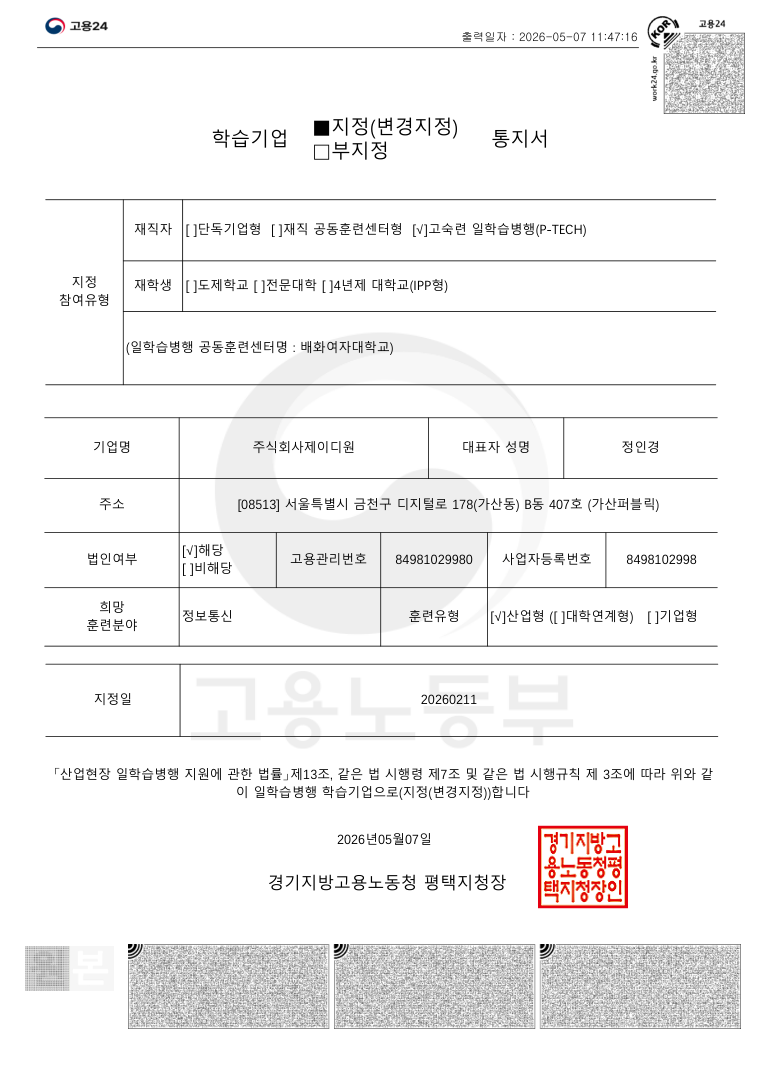
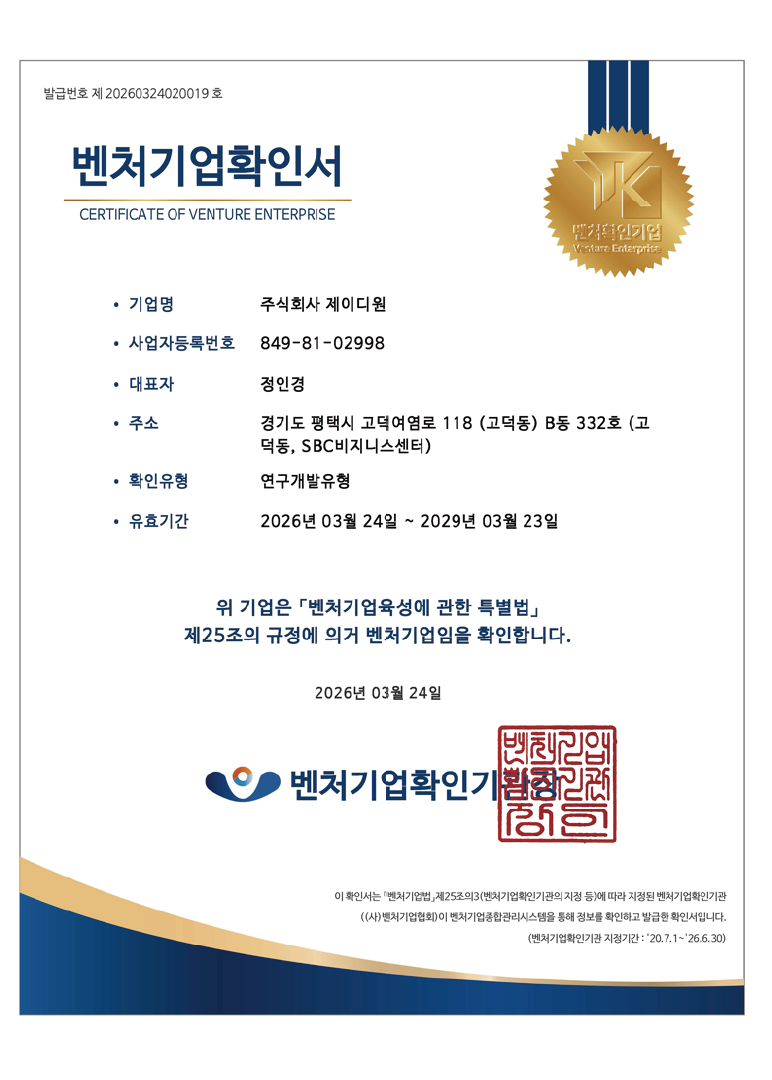
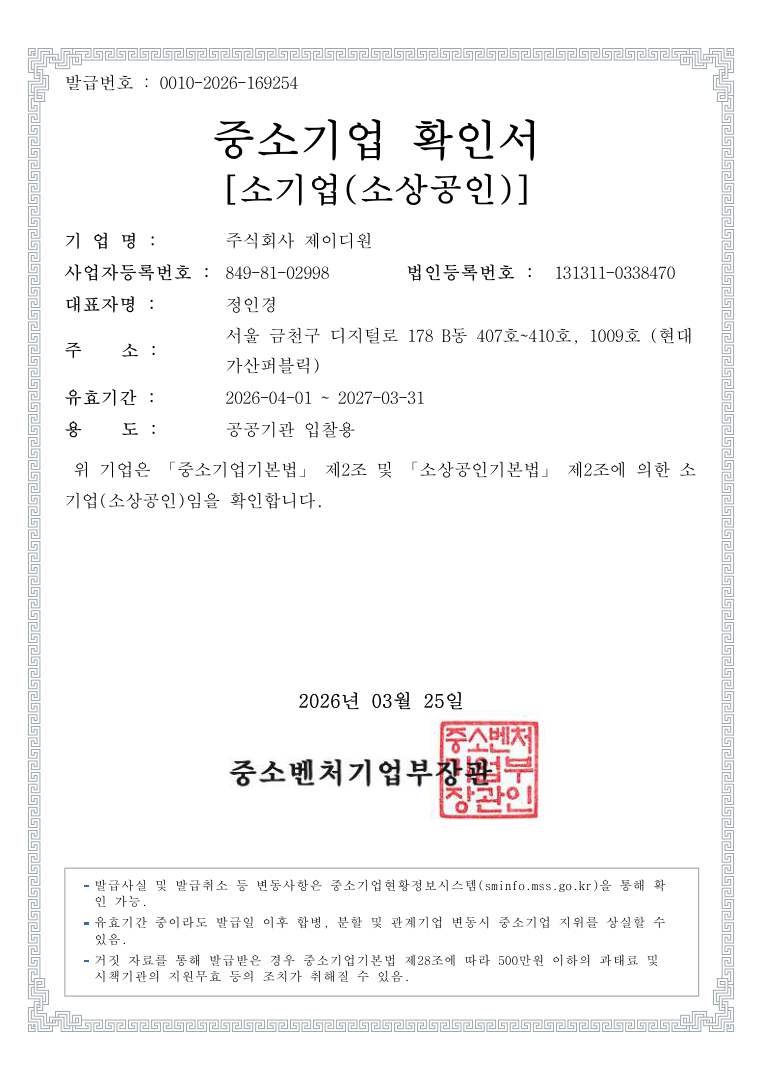
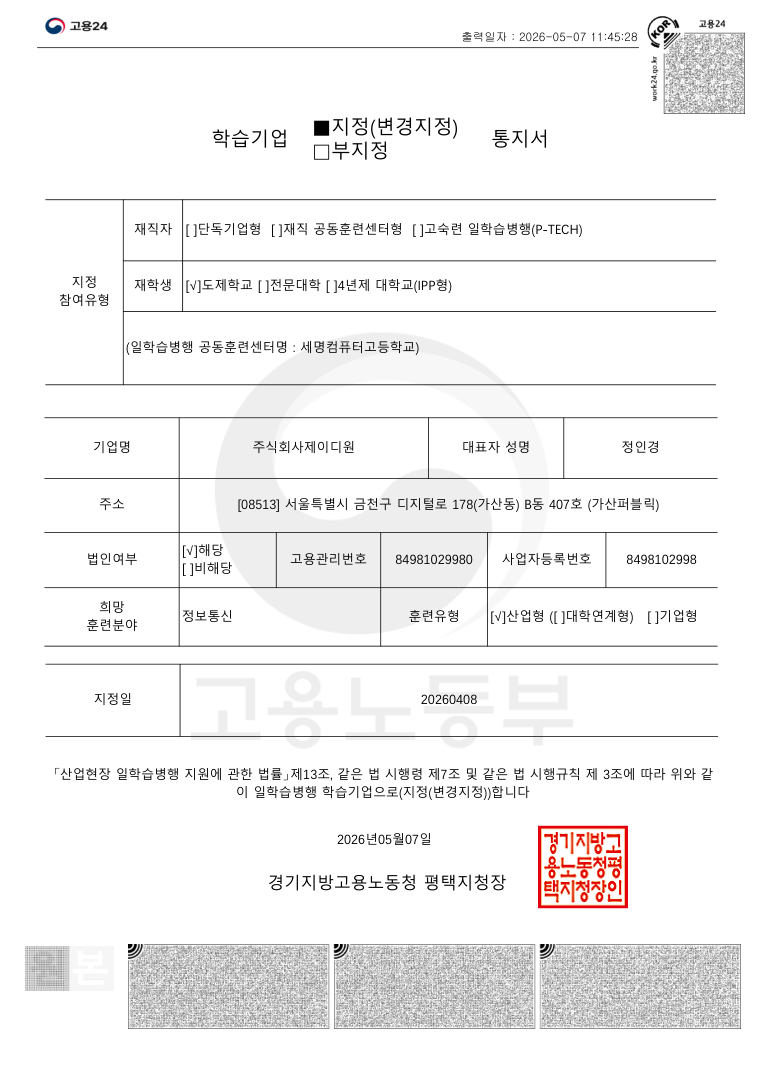
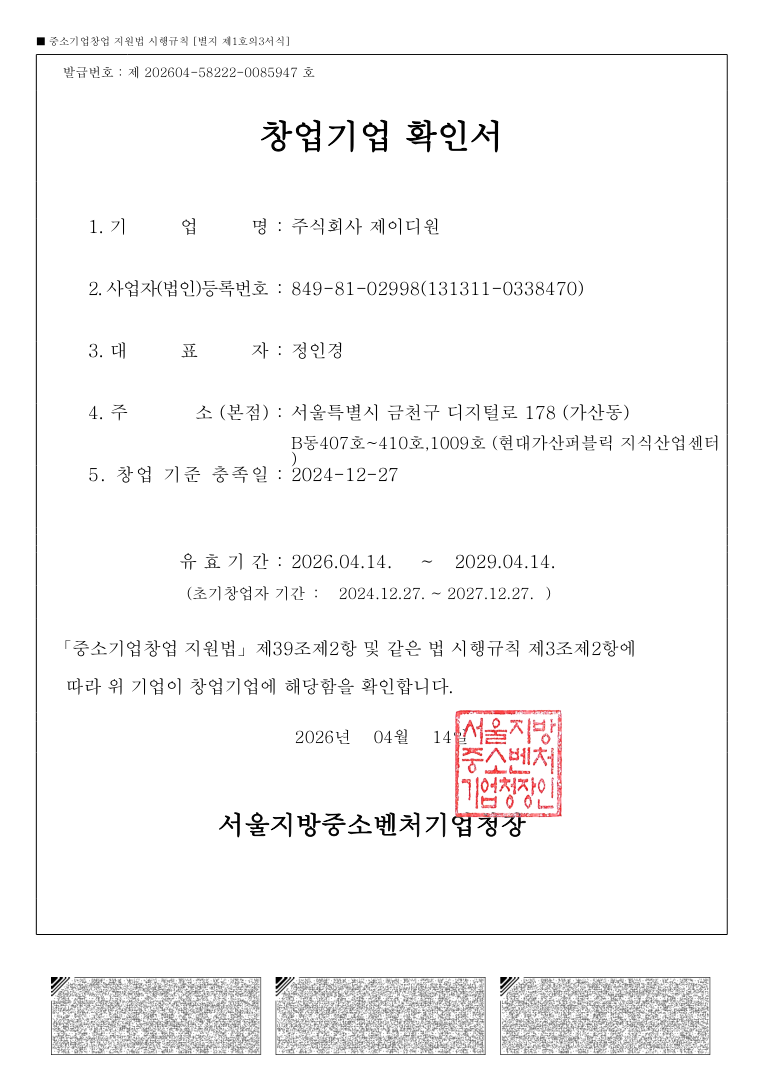
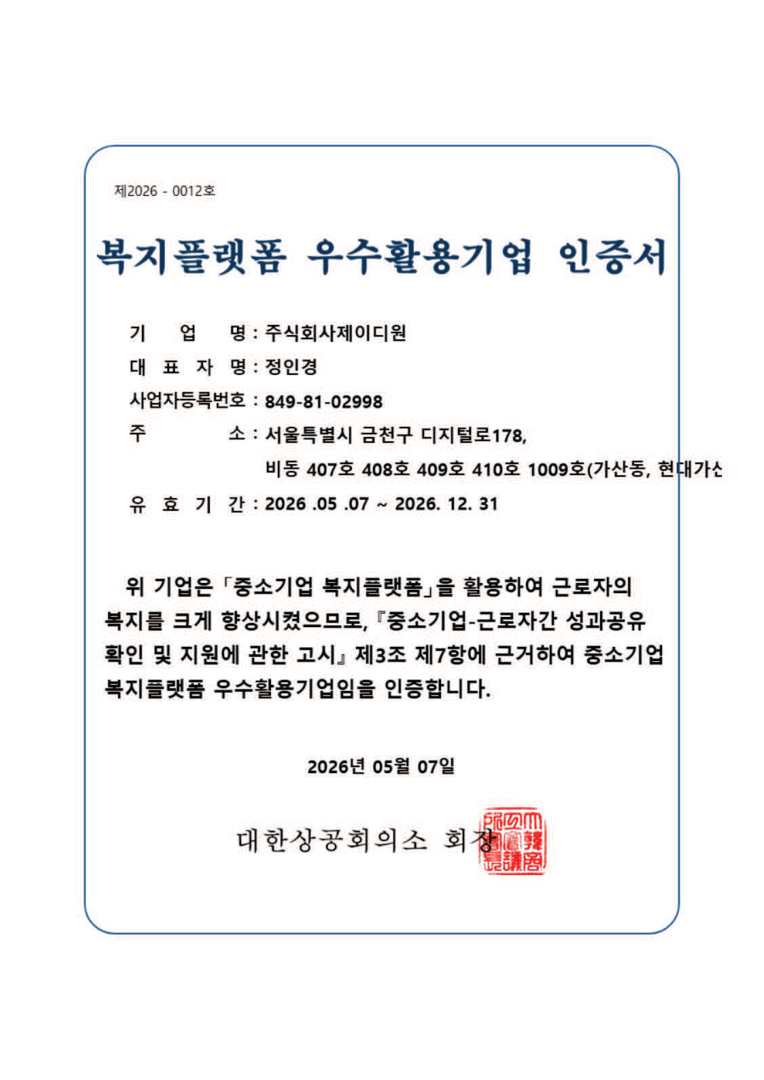
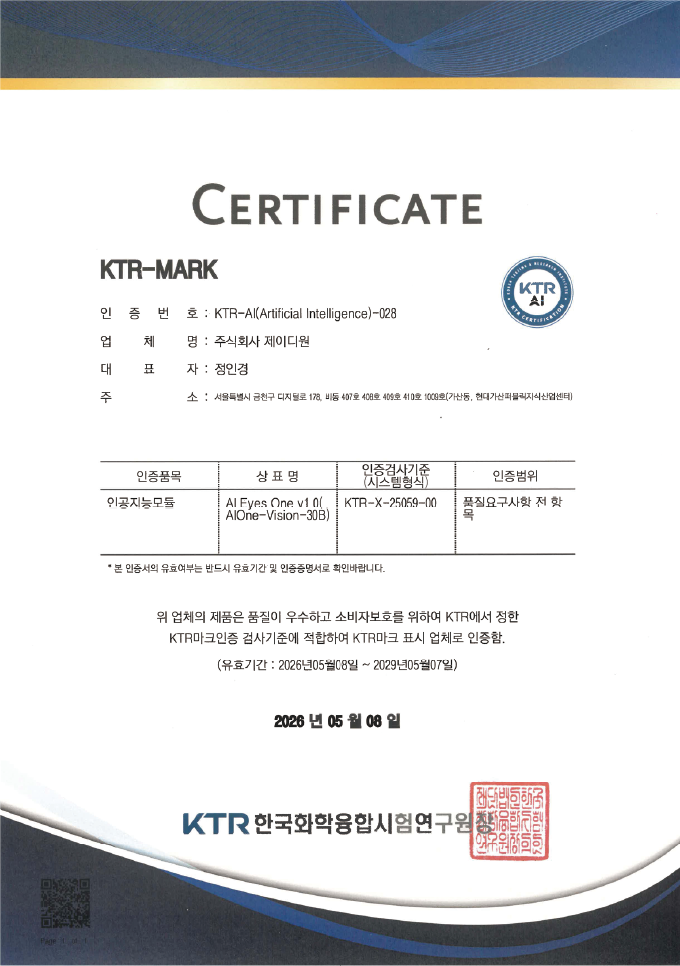
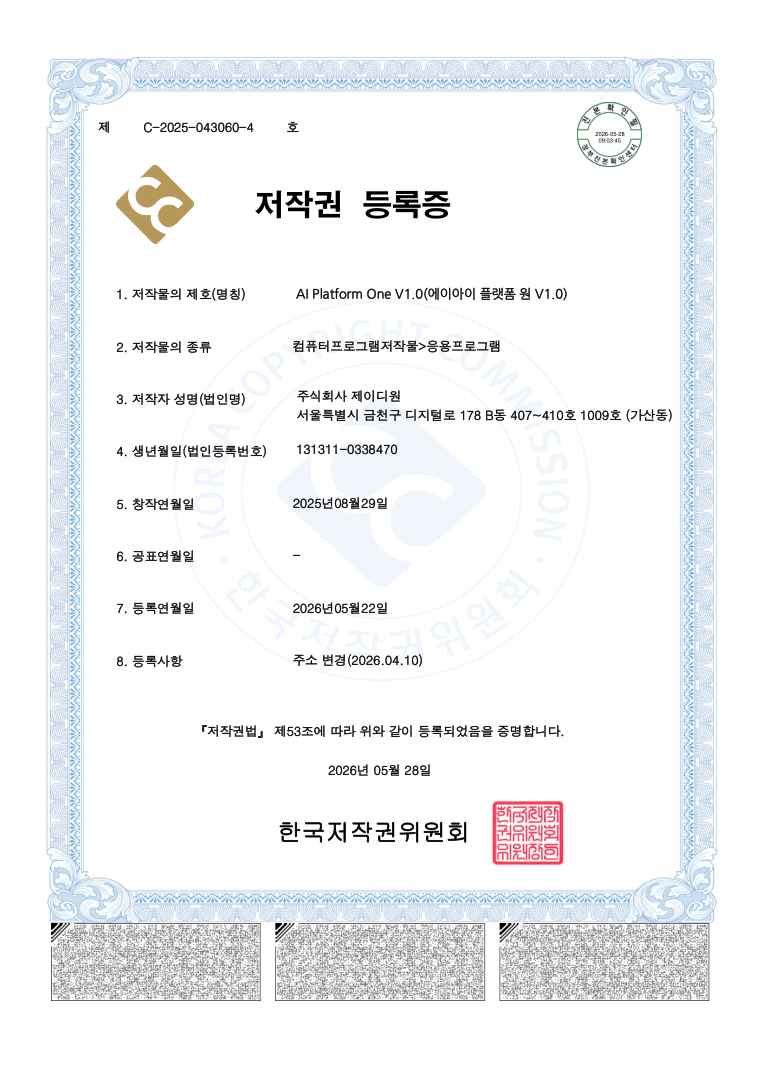
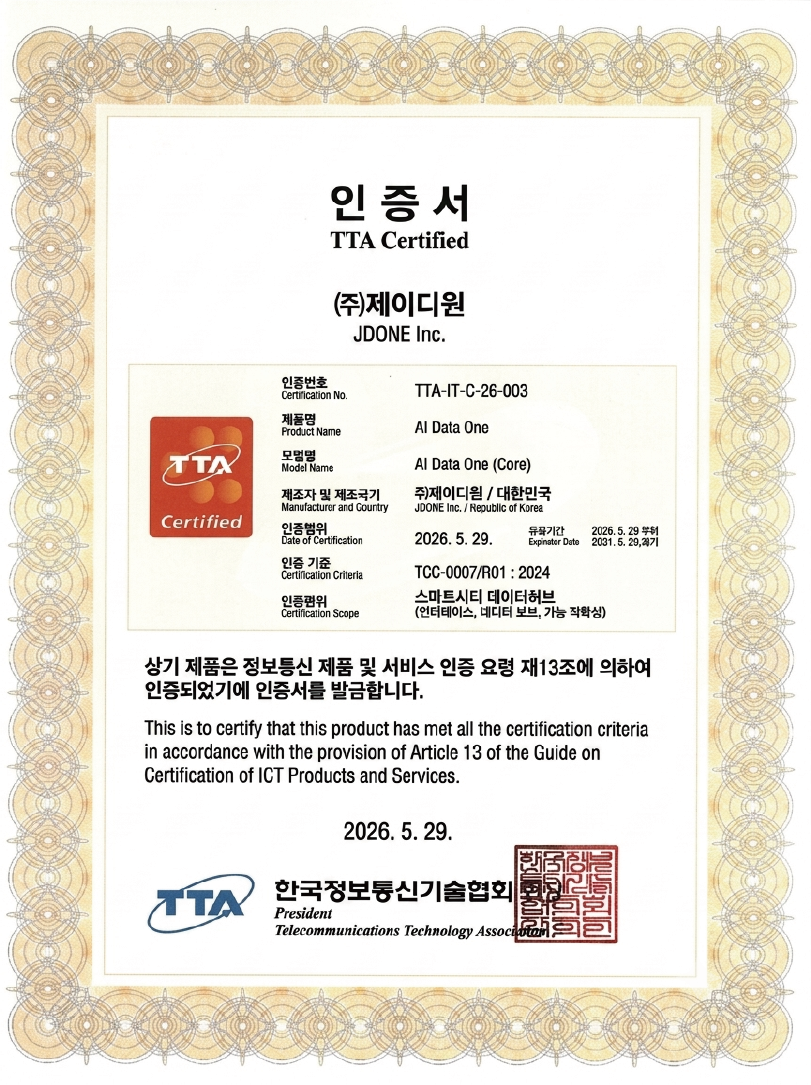
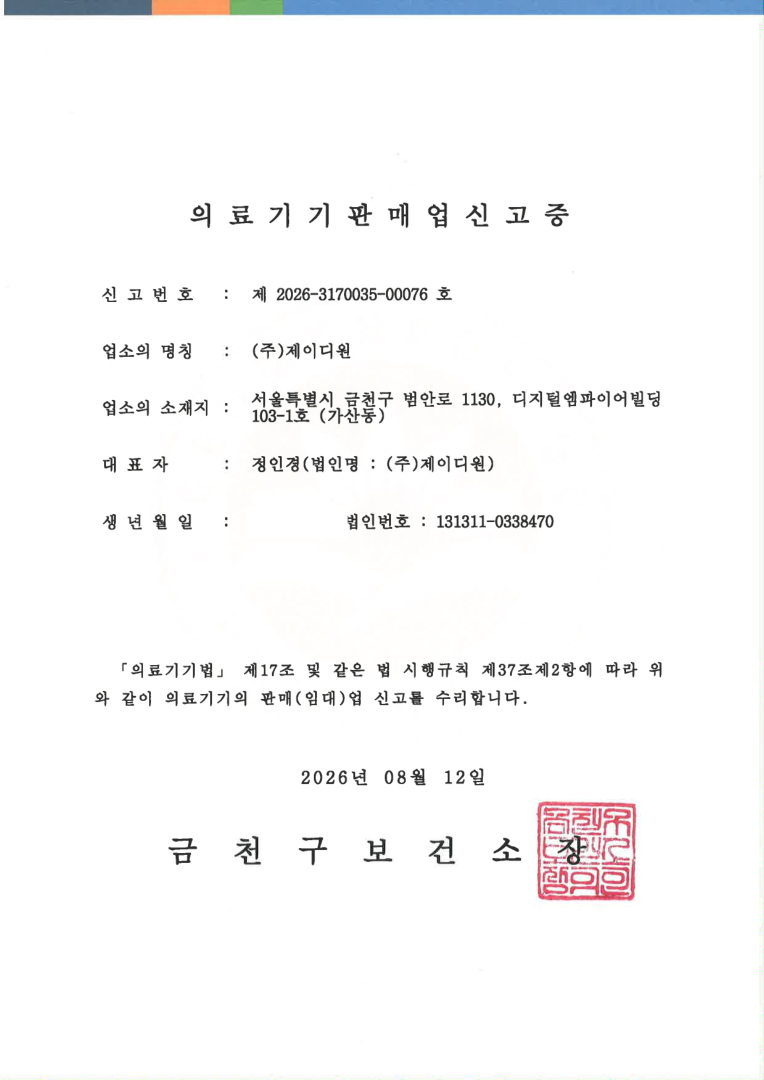
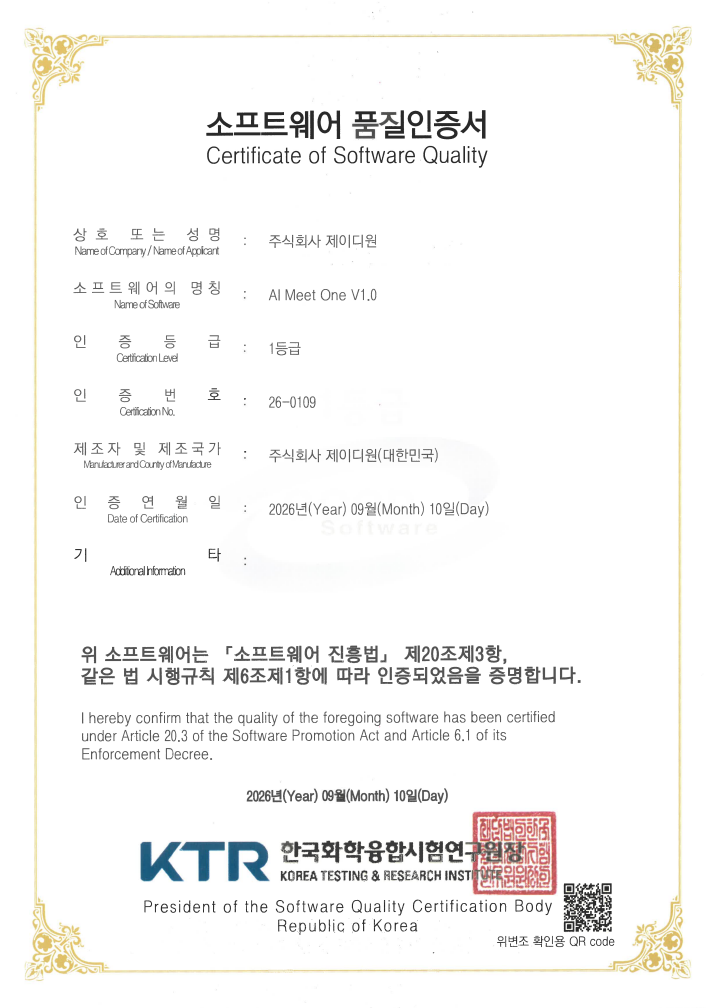
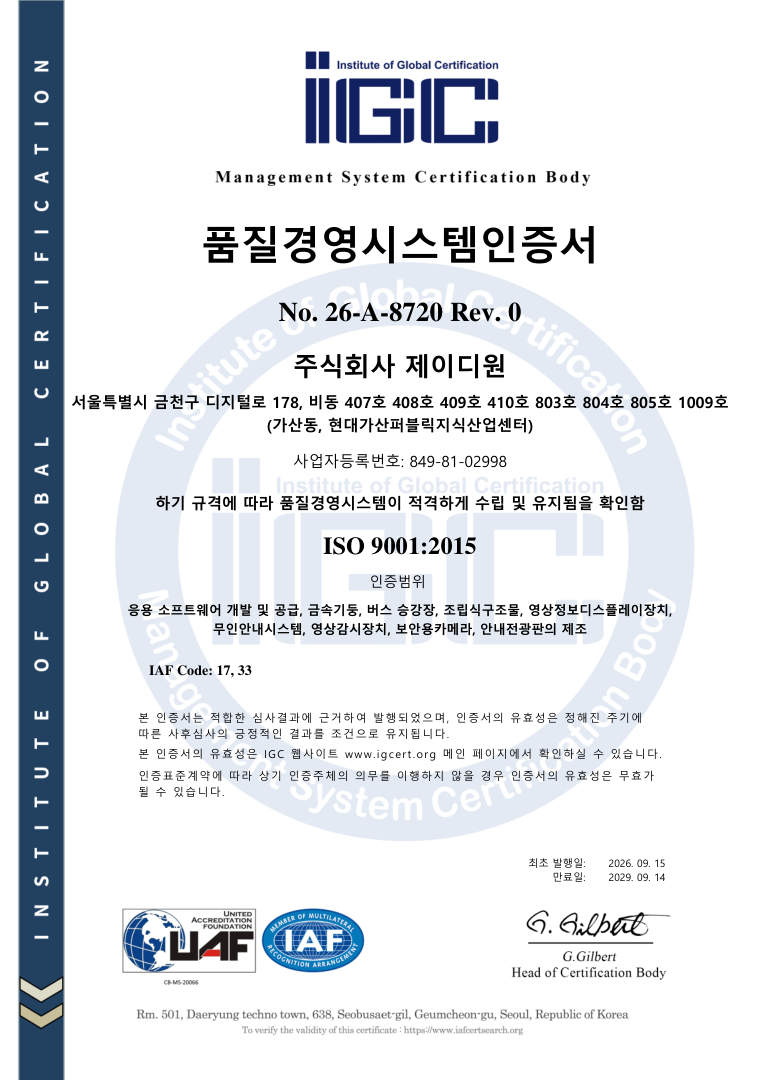
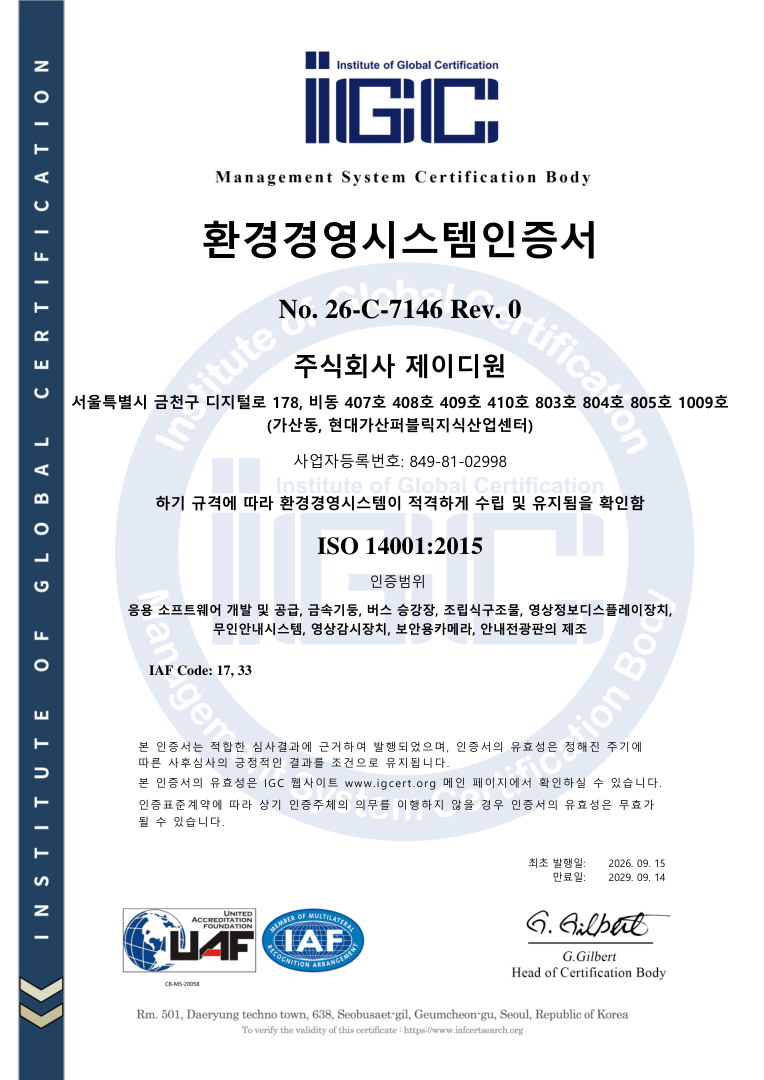
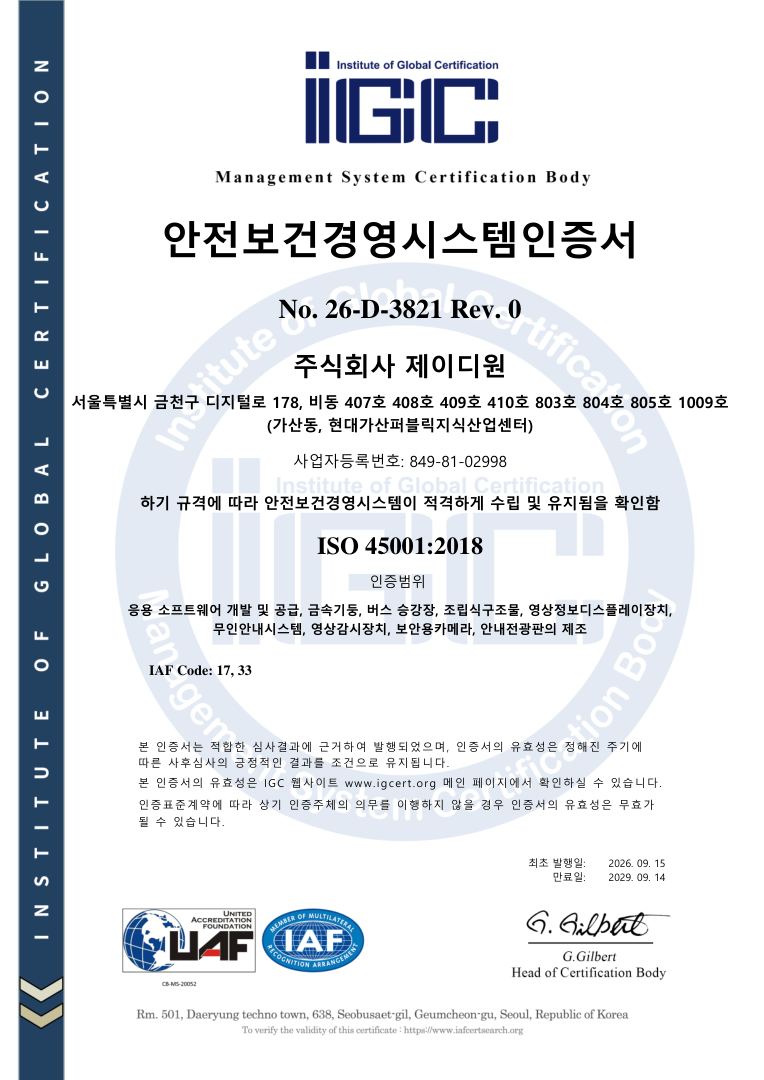
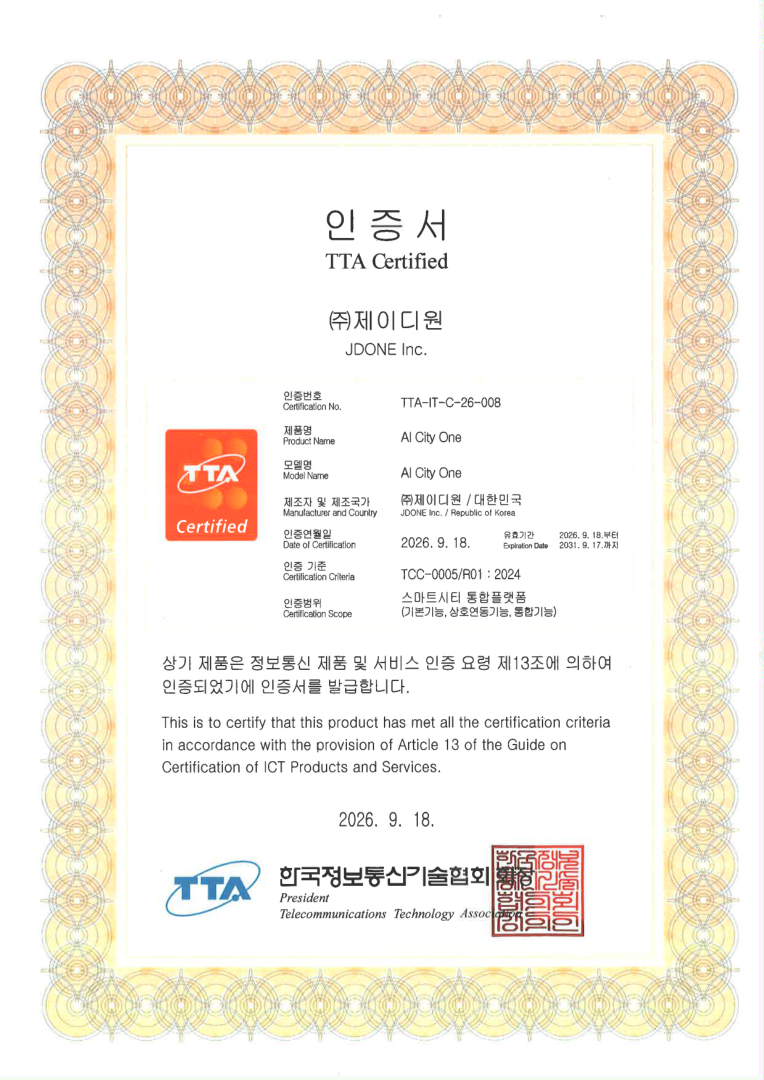
Official Certifications